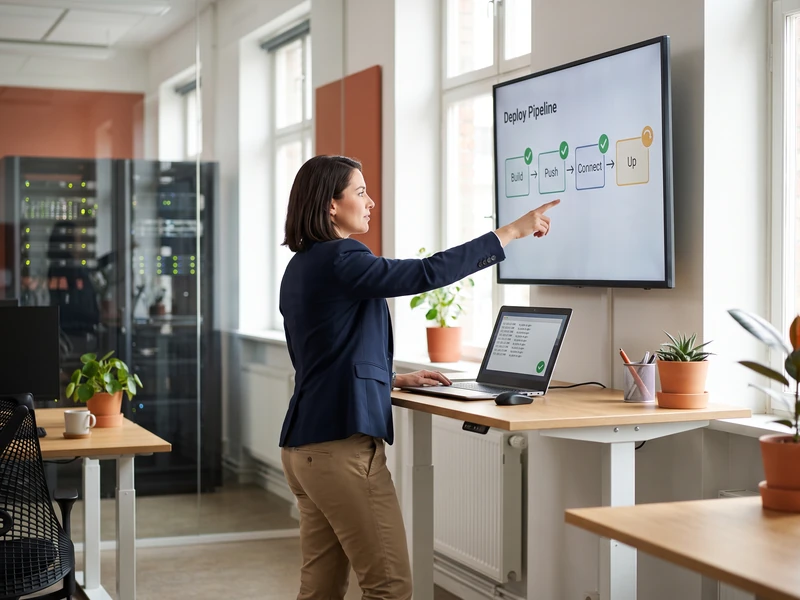

Jede App bekommt einen GitHub Actions Workflow pro Slot, gefiltert auf ihren eigenen Source-Pfad und ausgelöst durch einen Push auf den Branch dieses Slots. Der Run baut das Image, pusht es in die Registry, verbindet sich mit der Maschine und fährt den Service hoch. Der Compose Tag bleibt pro Service gleich dem gepushten Tag, jeder Run stellt sich an einem Lock auf der Box an, und dasselbe Muster läuft auf einer Cloud VM oder eigener Hardware.
Blue und Green Slots
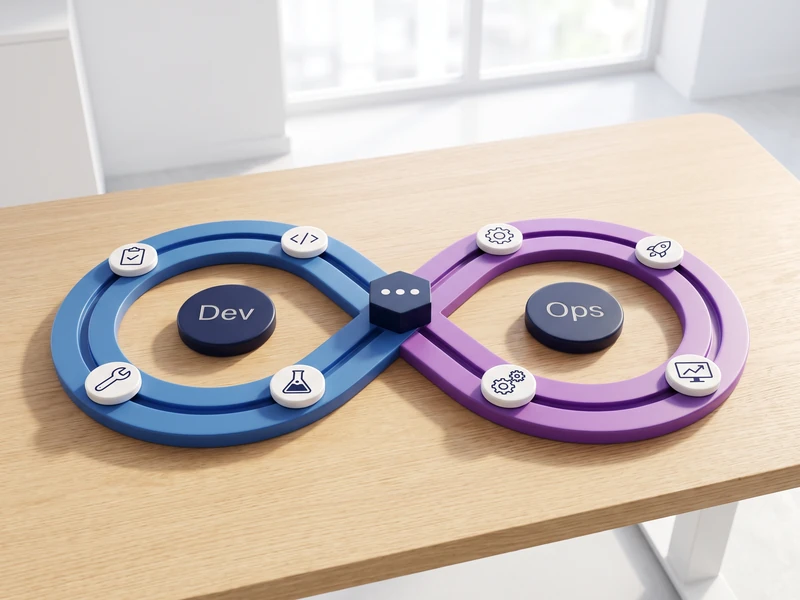
Jede App läuft ab dem ersten Deploy in zwei Slots: green aus dem main branch, blue aus dem candidate branch, mit eigenen Hostnamen und eigenem Env File. Beide teilen sich eine Maschine, der Candidate kostet nichts extra. Die Promotion taggt das auf blue getestete Image neu statt es neu zu bauen, der Rollback wird ein einziger Schritt. Jedes Release beweisen drei Fakten: Digest, Image ID des laufenden Containers und ein antwortender Hostname.

Claude Code als Harness
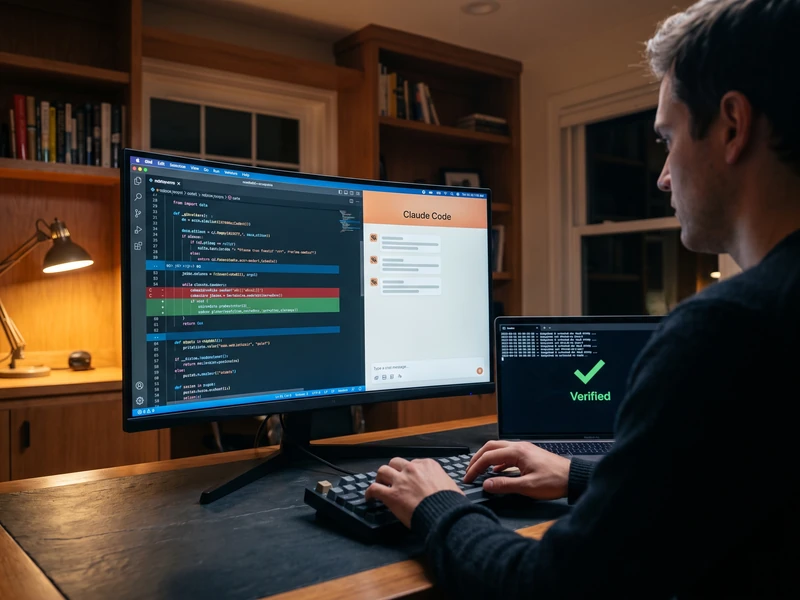
Claude Code arbeitet hier als Harness: Es schreibt den Workflow, den Compose Service und das SQL-Delta, fährt die Review-Lenses und meldet den geprüften Digest, statt nur Erfolg zu behaupten. Guard Hooks und ein Approval Gate legen fest, was unbeaufsichtigt laufen darf. Agents laufen über dieselbe Pipeline wie Apps, mit eigenem Workflow, zwei Slots und eigener Identity. GitHub Copilot coding agent und code review teilen sich dasselbe Repository.
Bleibt live
Kunden nutzen weiter die laufende Version, während die nächste Version getestet wird
Identischer Build
die Version, die Kunden bekommen, ist genau der Kandidat-Build, der sich bereits im Test bewährt hat
Schnellere Releases
jeder Push auf den Release-Branch startet die Pipeline automatisch, neue Features erscheinen so in gleichmäßigem Takt
Kandidat inklusive
die getestete Kandidatenumgebung läuft auf derselben Maschine, innerhalb des Hostings, das Sie bereits bezahlen
Eine Pipeline betreibt zwei Slots und beweist jedes Release
Bauen und Ausliefern 4 Schritte
01
Ein Workflow pro App und Slot
Ein Deploy, den nur eine Person im Kopf hat, bricht an genau dem Tag, an dem diese Person fehlt. Jede App bekommt ihren eigenen GitHub Actions Workflow pro Slot, gefiltert auf ihren Source-Pfad und ausgelöst durch einen Push auf den Branch, aus dem der Slot gebaut wird. Ein Release hängt damit nie von einem manuellen Befehl ab. Claude Code schreibt und pflegt diese Workflows im Repository, die Pipeline wird also reviewt wie jeder andere Code.
02
Einmal bauen, überall dasselbe Image ausführen
Wer das Release für jede Umgebung getrennt baut, riskiert einen Fehler, der erst in Production auftaucht, obwohl er beim Testen nie zu sehen war. Der Workflow baut das Image einmal, pusht es in die Registry und pullt und startet danach genau dieses Image auf der Zielmaschine. Der Tag auf der Box entspricht dabei pro Service immer dem gerade gepushten Tag: Es läuft, was getestet wurde.
03
Den Deploy beweisen statt ihn anzunehmen
Eine Pipeline, die nur Erfolg meldet, kann trotzdem die falsche Version laufen lassen oder gar keine erreichbare. Jeder Run prüft drei Fakten, bevor er als erledigt gilt: Das Image auf der Box trägt den gerade gepushten Digest, der laufende Container entspricht diesem Image, und der öffentliche Hostname antwortet. Zwei Slots liefen einmal fünfundzwanzig Stunden lang als healthy markiert, obwohl sie niemand erreichen konnte: Keiner der drei Checks allein hätte das aufgedeckt.
04
Nur ein Deploy gleichzeitig, auch unter Last
Landen zwei Releases gleichzeitig auf derselben Maschine, beschädigt sich der Deploy selbst, statt sauber zu scheitern. Jeder Run baut parallel, stellt sich aber vor jedem Zugriff an einem Lock auf der Zielmaschine an. So kollidieren gleichzeitige Releases nie mitten im Schreiben. Ein Push, der mehrere Workflows betrifft, kann trotzdem einen Run abbrechen, der gerade mitten im Deploy war. Deshalb schützt das Lock auf der Box die Maschine, nicht die Pipeline allein.
Blue und Green als Standard 3 Schritte
05
Blue und Green ab dem ersten Deploy
Wird ein Release erst getestet, nachdem es Kunden erreicht hat, wird aus einem schlechten Update schnell ein Incident. Jede App betreibt ab dem ersten Tag zwei Slots: green bedient Kunden aus dem main branch, blue trägt den Kandidaten ab demselben Tag, jeder mit eigenen Hostnamen und eigenem Env File. Beide teilen sich eine Maschine. Der Candidate kostet dadurch nichts extra, und niemand lässt ihn aus Kostengründen aus.
06
Promoten durch Retagging statt Neubau
Wird ein Image für die Promotion neu gebaut, kann die live gehende Version leicht von der abweichen, die tatsächlich getestet wurde. Images tragen keine umgebungsspezifischen Details fest eingebaut. Die Promotion taggt deshalb einfach das Image neu, das auf blue lief, statt es neu zu bauen. Ein unveränderlicher Tag macht den Rollback danach zu einem einzigen Schritt statt zu einem Notfall-Rebuild.
07
Ein Secret ändern, ohne zu raten, ob es angekommen ist
Ein neu gestarteter Container, der ein altes Secret behält, ist ein Fehler, den niemand bemerkt, bis irgendwo der falsche Wert verwendet wird. Ein Secret oder ein Connection String ändert sich über den Secrets MCP Server, mit Human-in-the-Loop, und der Container muss danach trotzdem neu erstellt werden, denn ein einfacher Restart allein behält den alten Wert. Einen neuen Hostnamen fügen Sie erst hinzu, wenn sein DNS-Record auflöst, damit die Zertifikatsvalidierung nie auf ein Problem wartet, das längst behoben ist.
Agents in der Pipeline 2 Schritte
08
Agents gehen durch dieselbe Pipeline wie Apps
Ein Agent oder eine Automation, die vom Laptop einer Person läuft, ist eine Abhängigkeit, die niemand sieht oder prüfen kann. Ein MCP Server, ein Agent Service oder ein geplanter Worker gilt als weitere App im Estate: Er bekommt einen eigenen Workflow, eigene zwei Slots und dieselben Release-Checks wie alles andere. Ein Tool, das ein Agent aufruft, beweist sich zuerst auf dem Candidate Slot, bevor es die Version erreicht, auf die sich Menschen tatsächlich verlassen.
09
Claude Code schreibt die Pipeline und arbeitet in ihr
Eine Pipeline, die nur ein Engineer versteht, stockt genau dann, wenn dieser Engineer anderweitig gebunden ist. Claude Code arbeitet hier als Harness: Es schreibt den Workflow und den Compose Service, fährt die Review-Checks und meldet den geprüften Digest, statt nur Erfolg zu behaupten. Guard Hooks und ein Approval Gate legen fest, was unbeaufsichtigt laufen darf. GitHub Copilot coding agent und code review passen in dasselbe Repository, für Teams, die sie bereits nutzen. Der Abgleich mit Ihrer eigenen Pipeline beginnt mit einem Blick auf das, was Sie heute deployen.
Häufige Fragen
Was heißt es konkret, ein gelandetes Release zu beweisen?
Drei Checks laufen nacheinander. Der Digest des gerade gepushten Images wird mit dem Image auf der Box verglichen; das stellt fest, dass der richtige Build dort liegt. Die Image ID des laufenden Containers wird mit diesem Image verglichen; das stellt fest, dass der laufende Prozess der deployte ist. Der öffentliche Hostname wird aufgerufen und muss antworten. Zwei Slots liefen einmal fünfundzwanzig Stunden lang healthy, obwohl sie niemand erreichen konnte, weil Container Layer, DNS Layer und Edge Layer jeweils für sich korrekt waren.
Heißt blue/green, ein zweites Environment zu bezahlen?
Beide Slots laufen auf derselben Maschine, mit eigenen Containern, Hostnamen und Env Files. Das Candidate Environment kostet deshalb keine eigene Hosting-Zeile, und die Datenbanken liegen auf einer gemeinsamen Instanz statt auf einem Service pro Projekt. Den Candidate Slot gibt es ab dem ersten Deploy, und genau das hält die Promotion beim Neu-Taggen eines getesteten Images statt bei einem Rebuild, den noch niemand laufen gesehen hat.
Dürfen Agents unbeaufsichtigt deployen?
Pro Environment, und die Grenze steht schriftlich fest, bevor der erste Run läuft. Read-only-Checks, Builds und Deploys auf den Candidate Slot laufen unbeaufsichtigt; alles, was den Production Slot berührt, geht durch ein Approval Gate, und Guard Hooks setzen die Grenzen durch, statt dass ein Reviewer sie im Kopf behalten muss. Jede Aktion trägt die eigene Identity des Agents, damit der Audit Trail ein Subject benennt und nicht einen geteilten Service Account.
Wie werden Secrets und Connection Strings geändert?
Ein Secrets MCP Server verwaltet Secrets und Connection Strings, mit Human-in-the-Loop, bevor sich ein Wert ändert. Der Container muss danach trotzdem neu erstellt werden, denn ein Restart allein behält den alten Wert: Das Env File bindet erst beim Erstellen des Containers. Werte liegen nie im Image und nie in einer Prozedurdatei, die die Datei nennt, in der ein Wert liegt, statt den Wert selbst.
